
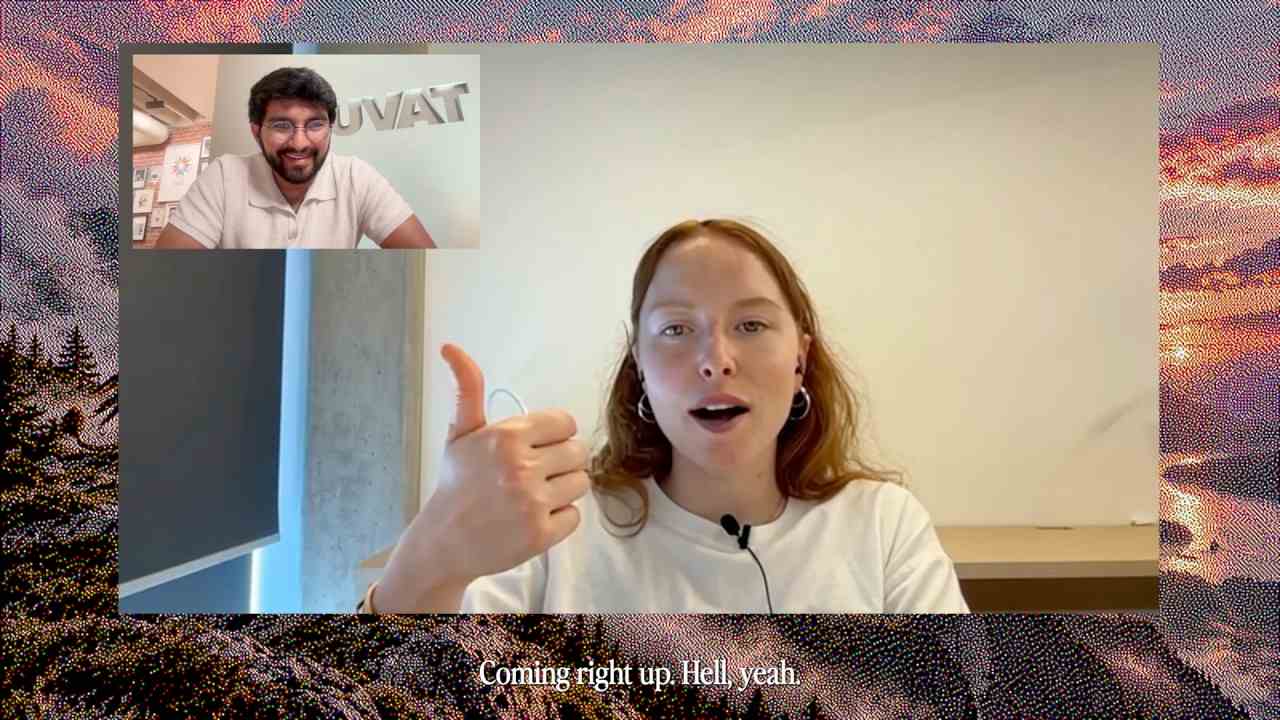
La compañía Tavus presentó Griffin, un nuevo modelo de interacción humana capaz de ver, escuchar, interpretar, hablar, moverse y reaccionar en tiempo real. Obtuvo 3,83 sobre 5 en una evaluación de NVIDIA y en una prueba independiente el 48% creyó estar hablando con una persona.
La inteligencia artificial conversacional está entrando en una nueva etapa: ya no se trata solamente de comprender una pregunta y generar una respuesta, sino de interpretar todo lo que sucede durante una conversación. Con esa premisa, Tavus presentó Griffin, un modelo que la compañía define como el primero de una nueva categoría denominada Human Interaction Model.
Griffin es un modelo de video a video y de interacción full-duplex que mantiene conversaciones cara a cara en tiempo real. Puede ver, escuchar, interpretar, hablar, moverse, reaccionar y responder de manera continua, de modo que aquello que percibe durante una conversación puede modificar lo que dice y hace en el momento.
La compañía sostiene que esta arquitectura busca cambiar la relación tradicional entre las personas y las computadoras. Hasta ahora, gran parte de la interacción con los sistemas de IA se produce mediante texto, comandos o voz. El objetivo de Griffin es que las máquinas puedan participar de una conversación de una manera más parecida a la comunicación humana.
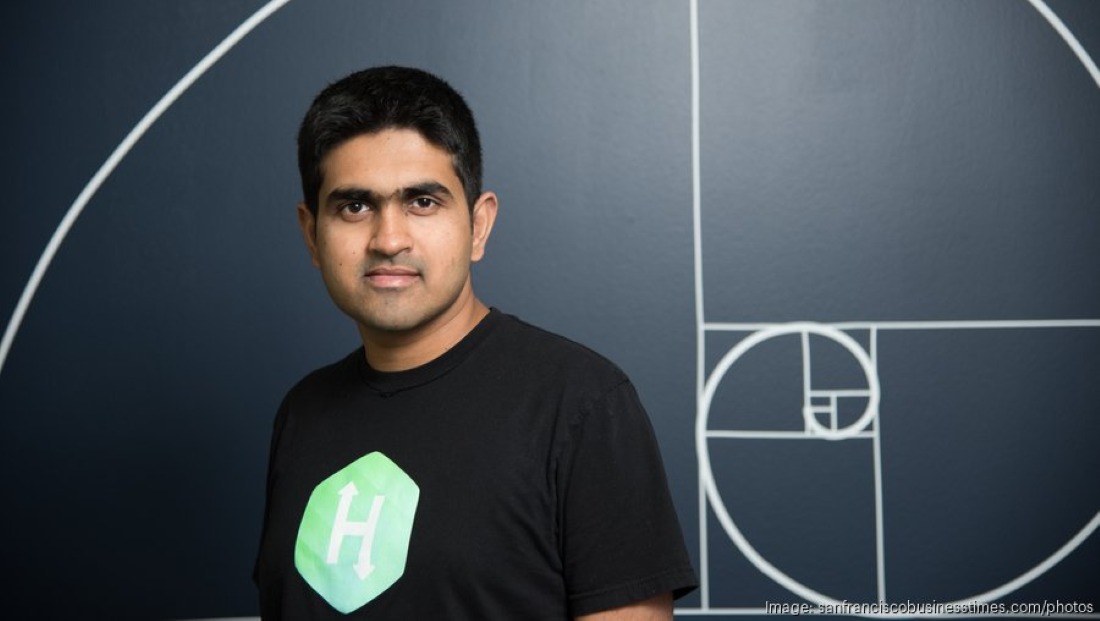
“La IA se ha vuelto increíblemente inteligente, pero todavía tenemos que encontrarnos con la máquina en sus términos. Griffin es un paso hacia el cambio de eso: hacia máquinas que entiendan cómo nos comunicamos naturalmente y que se encuentren con nosotros donde estamos”, afirmó Hassaan Raza, CEO de Tavus.
Un modelo que interpreta gestos, tono e interrupciones
Según Tavus, Griffin puede adaptar sus palabras, tiempos, tono, expresiones y movimientos a lo que sucede durante una conversación. Eso incluye reaccionar ante una interrupción, reconocer cuándo corresponde reírse o inclinarse hacia adelante o incluso saludar a alguien que acaba de entrar en una habitación.
La compañía sostiene que el modelo puede responder dinámicamente aunque la conversación tome un rumbo inesperado.
El resultado fue evaluado en VideoFDB, el benchmark de NVIDIA para este tipo de interacciones. Griffin obtuvo 3,83 puntos sobre 5 en generación, frente a una referencia humana de 3,92. El siguiente sistema publicado alcanzó 2,80.
La diferencia con el desempeño humano es pequeña dentro de esa medición, aunque se trata de una evaluación específica y no de una equivalencia general entre Griffin y una persona.
Otro estudio, realizado mediante una interacción en vivo, arrojó un resultado particularmente llamativo: el 48% de los participantes creyó que estaba conversando con una persona real y no con una inteligencia artificial.
Tavus sostiene que Griffin es posible gracias a años de investigación sobre diferentes componentes de la interacción humana. La compañía afirma que su equipo de investigación acumula trabajos citados más de 90.000 veces, mientras que más de 150.000 desarrolladores y empresas utilizan una o más de sus tecnologías.
Entre ellas se encuentra Phoenix-4.5, un modelo de renderizado en tiempo real diseñado para generar movimientos sutiles y comportamientos de escucha activa; Raven-1, orientado a la percepción multimodal para interpretar palabras, tono, expresiones y contexto visual; y Sparrow-2, enfocado en la dinámica de las conversaciones, incluyendo prosodia, interrupciones, respuestas breves y el entorno sonoro.
Griffin integra las investigaciones detrás de estos sistemas, pero Tavus plantea una diferencia fundamental: en lugar de considerar por separado la percepción, la conversación, el habla y el video, el nuevo modelo está diseñado alrededor de la interacción completa.
De un tutor virtual a un asistente que entiende lo que sucede
Para mostrar las capacidades de Griffin, Tavus presentó a Vanessa, uno de sus PALs, las representaciones humanas que interactúan con los usuarios. La compañía afirma que Vanessa es el PAL más realista que desarrolló hasta ahora y que funciona sobre Griffin.
Las aplicaciones potenciales incluyen un tutor que detecte que un estudiante tiene dificultades antes de que pueda formular una pregunta, una herramienta para ensayar una conversación complicada con un interlocutor capaz de reaccionar dinámicamente o un asistente de soporte que permita mostrar una pieza rota frente a la cámara y explicar el problema sin que el usuario siquiera conozca el nombre del componente.
La idea central es que la persona pueda comunicarse de la manera habitual, mientras el sistema intenta interpretar simultáneamente sus palabras, comportamiento y entorno.
Pero esa misma capacidad introduce un problema que Tavus reconoce explícitamente: cuanto más realista sea la interacción, más difícil puede resultar distinguir una IA de una persona.
Por ese motivo, la compañía decidió que Griffin-Lite esté inicialmente disponible únicamente para un grupo seleccionado de testers como una research preview. Tavus asegura que trabaja en mecanismos adicionales de divulgación y seguridad antes de ofrecer el modelo de manera más amplia.
El lanzamiento coloca a Griffin en una frontera cada vez más relevante de la inteligencia artificial: no solamente conseguir que las máquinas respondan correctamente, sino conseguir que entiendan y participen en la interacción humana en tiempo real.
La apuesta de Tavus es que la próxima generación de interfaces de IA no estará necesariamente basada en escribir instrucciones o hablarle a una máquina, sino en algo mucho más parecido a una conversación presencial.